购买建议
价格给力
价格给力
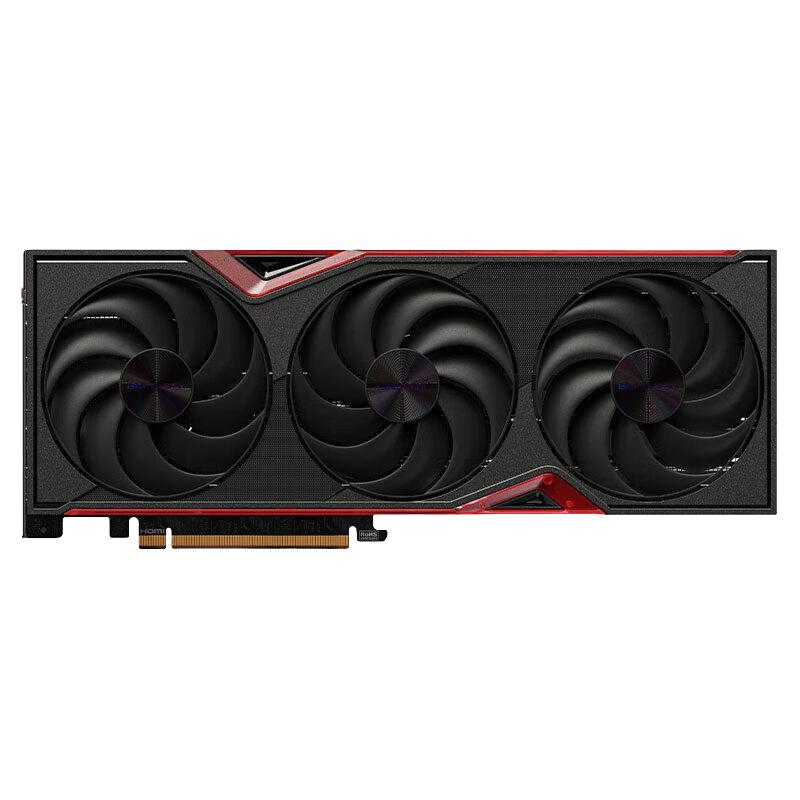
快科技10月27日消息,NVIDIA板卡合作伙伴透露,公司未收到RTX 5090停产通知,但已无法再订购GB202芯片与32GB GDDR7的完整套装,且不确定未来能否恢复下单。然而,官方口径与渠道现实之间的裂口正在扩大。NVIDIA高管Jeff Fisher本月中旬还公开强调RTX 5090“绝对没有停产”,仅承认供应链受限。但AIB厂商表示,以往供应紧张时仍可下延期订单,如今连这条路都被堵死,
这些年显卡圈的"跨界移植",方向一直是单向的:A饭一边刷B站教程、一边嫌AMD软件慢,然后把英伟达的DLSS往自己A卡上装。但这一周出了件反过来的事——英特尔锐炫的用户,把AMD最新的神经超分模型FSR 4.1.2装进了自家显卡,跑在自己的XMX矩阵核上,测出来的耗时和英特尔自家的XeSS打了个平手。这回,A饭坐到了围观席。先说事实:社区把FSR 4.1.2搬上了Arc卡,XMX硬件加速,接近原生
这周 HomeLab 圈被一个开源项目刷屏了:gpu-unlock,传闻"三行命令"就能解开英伟达锁在 30 系消费卡上的半速 AI 算力。RTX 3090 Ti 的 BF16 跑分从 87.5 冲到 157.4 TFLOPS,+80%,上线七天 GitHub 星标攒下三千多颗。连 Tom’s Hardware 都发了长文跟进。但瓜传着传着就变了味,什么"开核"“游戏帧数翻倍”——一半真一半假:锁
一、前言:补全锐炫Pro B系列的最后一块拼图进入2026年,本地AI推理与AI内容创作对显存的胃口仍在变大,一个27B级稠密模型在8bit量化下就要吃掉约31GB显存,即使4bit量化,如果想开128K长度的上下文,那也差不多要这么多显存;一套14B级视频生成工作流也动辄需要30GB以上余量。在这样的需求面前,“显存够不够”往往比“算力快不快”更能决定一项工作能否在本地跑起来。英特尔锐炫Pro
已收藏
去我的收藏夹